
nota · 2 de octubre de 2026
Una bandera no es una garantía
Cómo nats-trail empezó siendo otro GUI de NATS y terminó siendo un lugar donde un agente puede mirar producción sin poder tocarla.
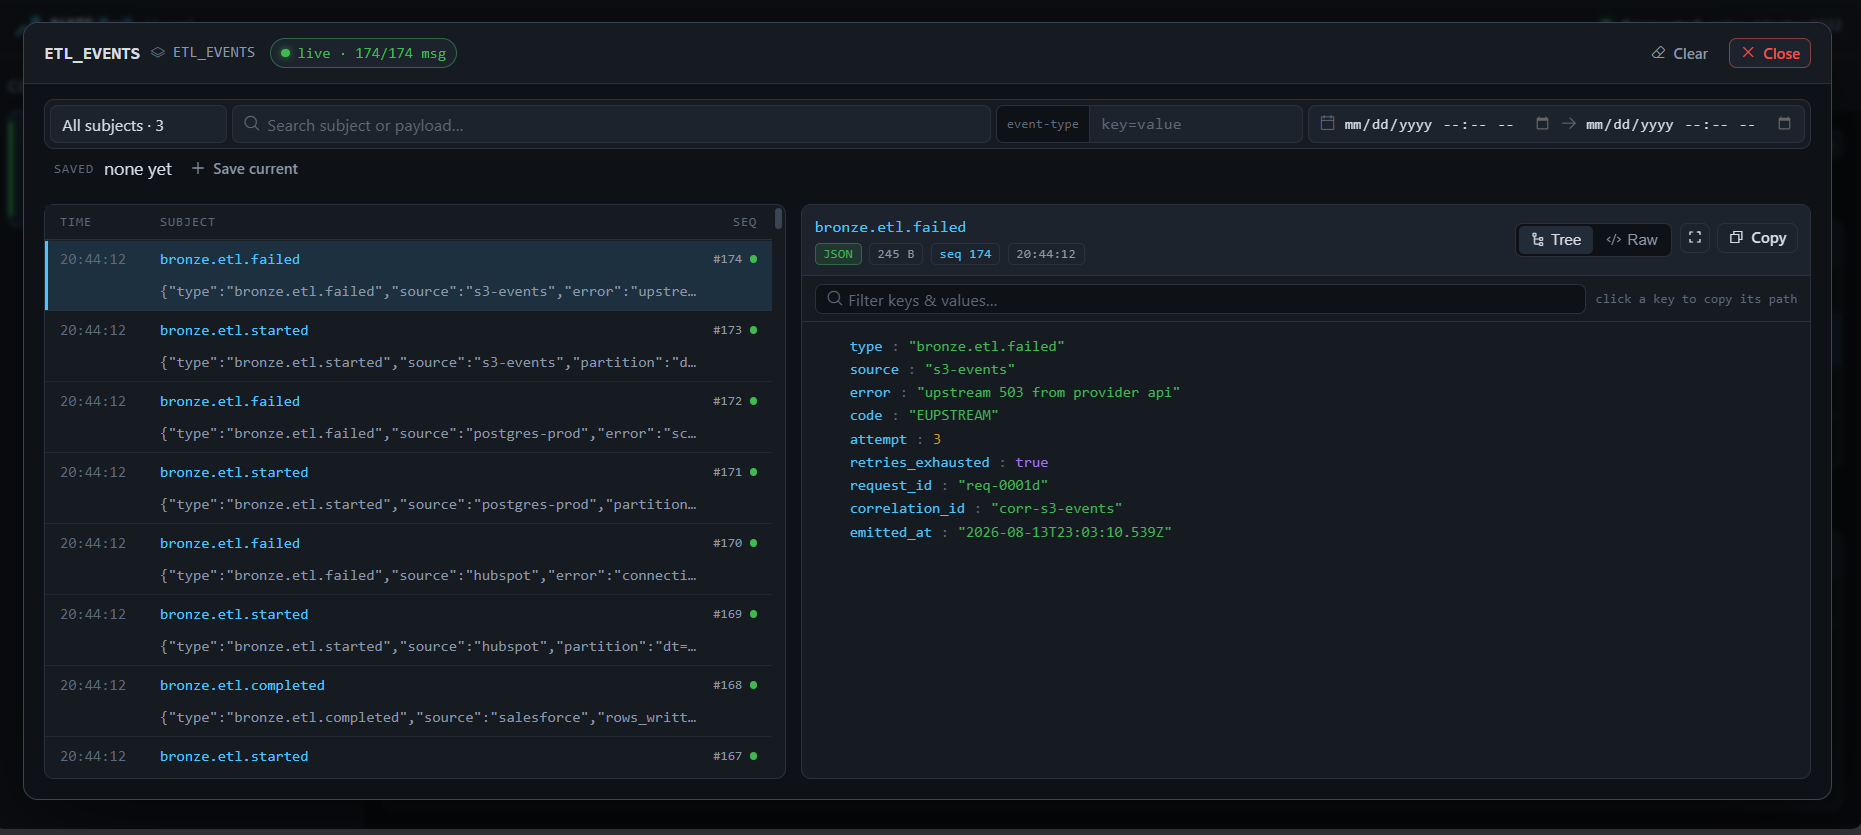
En un sistema orientado a eventos, la pregunta fácil es “¿qué hay en este stream?”. Todos los GUIs de
NATS la contestan, y la contestan bien. La pregunta difícil es otra: “¿por qué falló este flujo?”. Para
contestarla hay que seguir un request_id por cuatro streams, tres servicios y un subject de dead-letter,
y hoy eso se hace a mano, con una terminal por stream y la paciencia de quien arma un rompecabezas sin la
foto de la caja.
nats-trail contesta esa pregunta directamente: es una web UI, una CLI y un servidor MCP sobre un mismo motor de consultas acotado. Pero no nació así. Nació como un GUI más, y la historia de cómo dejó de serlo está entera en el historial de git, que es el único diario que llevo sin proponérmelo.
Primero hice lo que hace todo el mundo
El primer commit es del 29 de mayo. En tres días tenía lo que cualquiera esperaría: contextos de conexión,
paneles para Core y JetStream, replay y live tail con un consumer efímero, un visor de JSON con árbol y
búsqueda, detección de subjects de DLQ sin casarse con ningún vendor, y una guarda que te frena antes de
conectarte a un contexto marcado como prod o staging. El 1 de junio el commit dice, con toda la solemnidad del caso,
“complete v1 inspection gaps”. Y el siguiente dice “refactor design”, que es lo que uno escribe cuando
se da cuenta de que lo que terminó no era lo que quería.
Lo que quería no era otro panel. Ya existe NUI: es de dominio público, tiene más de 650 estrellas y binarios de escritorio para tres plataformas. Competirle en amplitud de GUI, sola, es una carrera que se pierde con elegancia o se pierde sin elegancia, pero se pierde. Lo dejé escrito en el roadmap, en la sección que más me gusta de cualquier roadmap: Explicitly not doing.
El que tenía que leer los streams no era yo
El 9 de junio hay un commit que cambia todo: “feat(core): add query envelopes for agents”. Ese mismo día y el siguiente entran los contratos de herramientas para CLI y MCP, el servidor stdio, timeouts, auditoría de cada llamada con su origen y validación estricta de los inputs: campos requeridos, tipos, rangos numéricos y campos desconocidos, antes de ejecutar nada.
La idea era simple. Si la pregunta difícil es seguir un flujo por cuatro streams, la que mejor la puede hacer no soy yo con cuatro terminales: es un agente con cuatro herramientas. Pero un agente no lee pantallas, lee contratos. Así que cada respuesta pasó a ser un sobre chico y aburrido, a propósito:
{
  "query": { "contextId": "dev", "limit": 50 },
  "summary": { "returned": 12, "truncated": false },
  "results": [],
  "nextCursor": null,
  "warnings": [],
  "errors": []
}
Lo aburrido es la parte interesante. Un humano tolera una respuesta ambigua porque la mira y entiende. Un modelo la completa con lo que le parezca más probable, que no es lo mismo que lo que pasó.
Un “no encontré nada” sin cobertura es una mentira con buena ortografía
El 10 de junio llegó el motor de consultas acotado, y es la decisión de la que más orgullosa estoy.
Escanear un stream entero para buscar un mensaje es la forma más honesta de buscar y la más cara. Así que cada escaneo tiene un presupuesto: por defecto 10.000 mensajes examinados, como mucho 100.000. Hasta ahí, nada raro; cualquier herramienta pone un límite. Lo que importa es qué pasa cuando el límite se toca.
- Si no le pasás ventana de tiempo ni cursor, la consulta cubre las últimas
maxScansecuencias y el sobre trae un warningquery.window_default: te contesté sobre una porción que elegí yo. - Si el escaneo se corta por presupuesto, vuelve un
nextCursorno nulo y un warningquery.scan_truncated: no miré todo, y acá está por dónde seguir.
Nadie:
Absolutamente nadie:
Un agente con un resultado vacío: “No hay errores en el stream de pagos.”
Ese es el bug que el contrato evita. El agente siempre sabe si la cobertura fue completa y cómo seguir. “No encontré nada en los últimos 10.000 mensajes” y “no hay nada” son dos frases distintas, y la segunda sólo se puede decir si se la ganó.
Una bandera no es una garantía
Todo esto vale poco si el agente, además de mirar, puede romper. La primera tentación es la obvia: un
flag --read-only. La descarté por la misma razón por la que existe: un flag se puede dar vuelta. Una
variable de entorno mal copiada, un config heredado, alguien apurado un viernes. Una garantía que depende
de que nadie toque una perilla es una sugerencia.
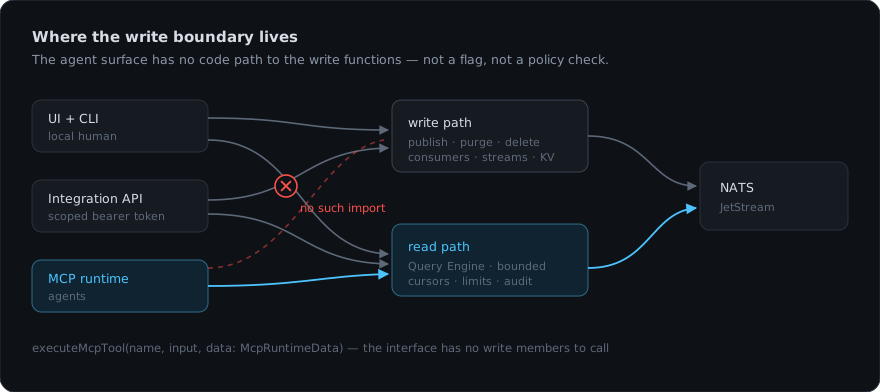
Así que la regla quedó estructural, no procedimental:
| Dónde | ¿Puede escribir? | Por qué |
|---|---|---|
Runtime MCP (McpRuntimeData) |
No, nunca | La interfaz que recibe no tiene miembros de escritura. No están deshabilitados: no existen. No hay nada que llamar. |
| UI y CLI | Sí | Sólo con una sesión humana autenticada o un token con scope write, y auditado con sus argumentos. |
| Cualquier flag, env var o config | No lo cambian | Ninguno puede hacer alcanzable una escritura desde executeMcpTool. |
Cuando en agosto llegaron las escrituras (editar y purgar claves de KV con concurrencia optimista, crear streams y consumers, request/reply, guardar objetos), entraron todas del lado humano. La fase entera se llama “Writes, on the human side only”, y tiene una línea arriba que dice que nada en ella puede debilitar esa regla.
Para los equipos que de verdad quieran que un agente escriba, el plan es un binario aparte,
natstrail-mcp-write, con su propio paquete y su propia interfaz. Instalarlo es un acto deliberado, con
otro nombre en la configuración del cliente MCP. Nunca va a ser un flag sobre natstrail-mcp, porque el
valor de decir “es de solo lectura” es justamente que no se puede apagar.
Dos meses de silencio y una fase cero
Después del 10 de junio el historial se queda callado hasta el 13 de agosto. No voy a fingir que fue una pausa estratégica. Lo que sí sé es lo que pasó cuando volví: abrí el roadmap y la primera fase decía “Nada más importa hasta que alguien que no sea la autora pueda correr esto.”
Tenía un motor de consultas acotado, auditoría, integración con Sentry y catorce herramientas MCP. No
tenía licencia, y sin licencia nadie puede usar legalmente el proyecto, por más bueno que sea. No estaba
en npm. El binario se llamaba nats-ui, nombre que en npm ya usa un paquete que no tiene nada que ver, así
que el alias no se deprecó: se tiró.
Ese día entró la licencia Apache-2.0, el build de los paquetes, la imagen de Docker con su
docker-compose y un nats-server -js al lado, el CI en Node 20 y 22 con un smoke test de serve, y las
capturas del README sembradas con datos de demo. npx nats-trail serve empezó a funcionar desde una
máquina limpia. Entre el 13 y el 15 de agosto el proyecto pasó de la 0.1.0 a la 0.5.0, que es lo que pasa
cuando el trabajo ya estaba hecho y faltaba la parte de que alguien lo pueda abrir.
Los tests encontraron lo que yo no
El 14 de agosto escribí la suite del motor de consultas: filtros, límites de los sobres, truncamiento y guardas sobre la frontera de escritura. 67 tests. Uno falló, y no por un test mal escrito:
// The > wildcard matches one or more remaining tokens, never zero:
// the pattern orders.> must not match the bare subject orders.
if (token === ">") return s.length > i;
Antes decía return true. En NATS, orders.> matchea orders.created y orders.eu.paid, pero no
orders a secas. Mi implementación sí lo matcheaba. Es un bug chiquito, de esos que nadie ve en una demo
y que en producción te muestran mensajes que no pediste, con total convicción. Lo interesante no es que
existiera; es que llevaba ahí desde mayo, en un proyecto que yo usaba, y no lo había notado nunca. Lo que
uno usa todos los días es exactamente lo que uno deja de mirar.
Lo que no hago, a propósito
Las decisiones que más me ordenan son las que dicen que no:
- No compito con NUI en amplitud de GUI. Ya ganó, y se lo merece.
- No administro clusters ni topología. Eso es el producto de Synadia Control Plane. La visibilidad de cluster quedó diferida, no rechazada, y la diferencia está escrita.
- No hay escrituras de agente detrás de un flag. Ver arriba, con insistencia.
- No paso payloads del Object Store por el bridge. Sólo metadata.
- No decodifico nombres de campos de protobuf. El formato wire sí, sin esquema y sin dependencias; los nombres necesitan un registro de esquemas por subject, y eso es otro proyecto.
- No estoy en Smithery. Ahora pide un bundle
.mcpb, que es un artefacto de distribución nuevo, no un archivo de configuración. Sí estoy en el registro de MCP, republicado en cada tag.
El índice de correlación sigue la misma lógica que las escrituras: es opcional por stream, vive en
node:sqlite (por eso el piso es Node 22), y construirlo es una acción humana. Consultarlo es
automático. El agente aprovecha el índice; no decide cuándo hacerlo.
Los hitos
| Fecha | Qué pasó |
|---|---|
| 29 may | Primer commit: contextos, paneles de Core y JetStream |
| 1 jun | “v1 completa” y, acto seguido, refactor design |
| 9 jun | Sobres para agentes, contratos de CLI y MCP, auditoría |
| 10 jun | Motor de consultas acotado, tokens, pool de conexiones |
| 13 ago | Fase cero: licencia, npm, Docker, CI, renombre a nats-trail |
| 14 ago | Tests, el bug del >, trace de flujos, escrituras del lado humano |
| 15 ago | Protobuf y msgpack sin esquema, PagerDuty, índice de correlación, Helm chart, v0.5.0 |
Lo que me enseñó un event bus
Arranqué haciendo una herramienta para mirar, y terminé haciendo una herramienta sobre los límites de mirar. Casi todo lo que vale la pena en nats-trail es una forma de decir hasta acá: hasta acá escaneé, hasta acá te dejo llegar, hasta acá llega este binario. Me sorprendió lo mucho que eso cambia la relación con un agente. Un modelo no necesita que le confíes producción; necesita que le digas con precisión qué parte de producción vio, y que no exista ninguna versión de la conversación en la que pueda tocarla.
La otra lección es más silenciosa. Pasé dos meses con un proyecto que funcionaba y que nadie más podía usar, y en mi cabeza estaba “casi listo”. No lo estaba. Una licencia, un nombre libre en npm y un comando que anda en una máquina limpia valen más que la siguiente feature, porque son la diferencia entre algo que existe y algo que yo sé que existe. Lo que sigue (multiusuario, visibilidad de cluster) son preguntas de diseño abiertas, y prefiero dejarlas escritas como preguntas antes que fingir que ya tienen respuesta.
Sol Soletti
- #NATS
- #MCP
- #agentes
- #nats-trail